Anexo 2: Técnicas de optimización, compresión y mitigación de desafíos en Small Language Models (SLM)¶
La viabilidad de los modelos de lenguaje pequeños (Small Language Models, SLMs) y sus variantes multimodales de visión (Small Vision-Language Models, sVLMs) en plataformas robóticas autónomas reside en su capacidad para aproximar la competencia de razonamiento de los grandes modelos fundacionales bajo presupuestos severamente restringidos de cómputo, memoria y energía (Abdin et al., 2024; Nguyen et al., 2024).
Este anexo sistematiza los principios teóricos y metodológicos de optimización que hacen posible este equilibrio: examina los tres pilares de compresión (destilación, poda y cuantización), revisa los avances arquitectónicos en eficiencia y adaptación en borde, analiza críticamente la propensión a alucinaciones en modelos compactos, y detalla los mecanismos de ingeniería adoptados en esta tesis para mitigar dichos riesgos en el lazo de navegación de un vehículo aéreo no tripulado (UAV).
A2.1 Paradigmas fundamentales de compresión de modelos¶
La reducción del orden de magnitud en el conteo de parámetros sin degradar de manera catastrófica la precisión y capacidad de generalización se articula mediante tres técnicas complementarias:
A2.1.1 Destilación de conocimiento (Knowledge Distillation)¶
La destilación de conocimiento consiste en transferir las distribuciones de probabilidad y las representaciones latentes aprendidas por un modelo «maestro» (teacher) de gran escala hacia una red «estudiante» (student) más compacta (Hinton et al., 2015).
- Supervisión densa: a diferencia del entrenamiento supervisado tradicional basado únicamente en etiquetas duras (one-hot), el modelo estudiante aprende a replicar las probabilidades suaves (soft targets) del maestro, capturando correlaciones cruzadas implícitas y matices semánticos que no están presentes en los datos de entrada brutos.
- Alineación de razonamiento: modificaciones en la función de pérdida de destilación permiten transferir cadenas de inferencia paso a paso (Chain-of-Thought, CoT), facultando a modelos sub-4B para resolver problemas de lógica simbólica, descomposición de metas y razonamiento espacial con fidelidad comparable a redes sustancialmente mayores.
- Destilación multi-maestro: arquitecturas especializadas integran ensambles de múltiples modelos maestros (e.g., un maestro de visión y otro de razonamiento textual) para destilar un único modelo compacto unificado.
A2.1.2 Poda de parámetros (Pruning)¶
La poda consiste en eliminar sistemáticamente ponderaciones redundantes o conexiones poco informativas dentro de las matrices de peso de la red, reduciendo el conteo de operaciones y la huella de memoria:
- Poda no estructurada (Unstructured Pruning): suprime ponderaciones individuales cuyos valores absolutos o gradientes caen por debajo de un umbral específico, generando matrices dispersas (sparse). Algoritmos de segunda derivada como SparseGPT (Frantar & Alistarh, 2023) permiten podar modelos masivos en una sola pasada (one-shot) sin necesidad de reentrenamiento extensivo. No obstante, aprovechar la aceleración teórica de la poda no estructurada exige hardware especializado con soporte nativo de aceleración dispersa (e.g., patrones \(2:4\) o \(n:m\)).
- Poda estructurada (Structured Pruning): retira bloques completos de la arquitectura, tales como neuronas completas, cabezas de atención (attention heads) o capas Transformer completas. Aunque puede inducir una degradación más abrupta si la tasa de remoción es excesiva, preserva matrices densas compatibles de forma nativa con cualquier biblioteca de álgebra lineal y GPU estándar.
A2.1.3 Cuantización (Quantization)¶
La cuantización sustituye las representaciones numéricas de alta precisión (típicamente punto flotante de 16 o 32 bits, FP16/FP32) por representaciones discretas enteras de bajo número de bits (INT8 o INT4), reduciendo drásticamente la memoria requerida para almacenar los pesos y acelerando el rendimiento computacional de las unidades de cálculo matricial (Frantar et al., 2022):
- Cuantización post-entrenamiento (Post-Training Quantization, PTQ): metodologías como GPTQ (Frantar et al., 2022) y AWQ (Activation-aware Weight Quantization) formulan la compresión como un problema de optimización cuadrática por capas, cuantizando los pesos mientras compensan el error de reconstrucción basándose en la información de segundo orden de la matriz Hessiana.
- Cuantización del caché de claves y valores (KV Cache Quantization): en tareas de inferencia de secuencias continuas o históricas, la KV cache constituye la principal causa de crecimiento dinámico de VRAM. Reducir la precisión de estos tensores a INT8 o INT4 permite sostener ventanas de contexto prolongadas sin desbordar la memoria de video disponible.
- Tratamiento de valores atípicos (Outliers): esquemas como SmoothQuant mitigan la dificultad inherente a la cuantización de activaciones migrando la escala dinámica entre pesos y activaciones antes de la cuantización, asegurando estabilidad numérica en modelos autoregresivos.
A2.2 Arquitecturas compactas y optimización para inferencia en borde¶
Más allá de la compresión directa de redes preexistentes, el diseño arquitectónico nativo de modelos compactos ha introducido mejoras estructurales orientadas a dispositivos con recursos limitados (edge computing):
A2.2.1 Diseños ligeros y optimizaciones de atención¶
Modelos como MobileLLM (Liu et al., 2024), TinyLlama (Zhang et al., 2024) y la familia Phi (Abdin et al., 2024) demuestran que optimizar la profundidad frente al ancho de la red, compartir matrices de incrustación (embedding sharing) y adoptar mecanismos eficientes de atención permite que modelos de escala 1B a 4B alcancen competencias operativas antes restringidas a modelos de decenas de miles de millones de parámetros.
Asimismo, la sustitución o combinación de la autoatención cuadrática convencional \(\mathcal{O}(N^2)\) por mecanismos de atención lineal, ventanas deslizantes (sliding window attention) o formulaciones basadas en modelos de espacio de estados (SSM) alivia sustancialmente la carga computacional en inferencias continuas.
A2.2.2 Ajuste fino eficiente en parámetros (PEFT, LoRA y QLoRA)¶
El reentrenamiento completo (full fine-tuning) de un modelo exige almacenar en memoria los estados del optimizador, activaciones intermedias y gradientes para la totalidad de los parámetros, lo cual supera con creces la memoria disponible en GPUs de consumo.
Las técnicas de ajuste fino eficiente en parámetros (Parameter-Efficient Fine-Tuning, PEFT), y en particular la adaptación de bajo rango (LoRA; Hu et al., 2022), resuelven esta barrera: * Congelan las ponderaciones preentrenadas \(W_0 \in \mathbb{R}^{d \times k}\) y modelan la actualización mediante la descomposición en dos matrices de bajo rango \(B \times A\), donde \(r \ll \min(d, k)\): $\(W = W_0 + \Delta W = W_0 + B \cdot A\)$ * Reducen el conteo de parámetros entrenables en más de un 99%, permitiendo especializar modelos en tareas de navegación o seguimiento de formatos en pocas horas de GPU. * Su variante cuantizada, QLoRA (Dettmers et al., 2024), mantiene el modelo base en precisión de 4 bits (NormalFloat4) e inserta adaptadores LoRA entrenables en precisión de 16 bits, posibilitando la especialización local sin incurrir en consumo masivo de VRAM.
A2.2.3 Transferencia y destilación de razonamiento¶
Los modelos compactos entrenados sobre datos sintéticos curados de alta calidad pedagógica (como libros de texto sintéticos y trazas lógicas depuradas) exhiben una capacidad desproporcionada para el seguimiento de instrucciones y la descomposición algorítmica de problemas (Abdin et al., 2024). Esto valida que la capacidad de razonamiento operativo de un modelo en un lazo de control no está determinada exclusivamente por el volumen bruto de parámetros, sino por la densidad informativa y estructurada del corpus con el que fue optimizado.
A2.3 El desafío de las alucinaciones en modelos compactos y visión-lenguaje¶
El fenómeno de la alucinación —definido como la generación de información fáctica o contextualmente incorrecta, no fundamentada en la entrada sensorial ni en la evidencia provista (Ji et al., 2023)— adquiere una gravedad particular en sistemas de robótica móvil e interacción física con el entorno.
A2.3.1 Correlación entre escala de parámetros y propensión alucinatoria¶
La literatura experimental documenta que los modelos de menor tamaño presentan una propensión basal más alta a generar contenido alucinatorio en comparación con modelos de frontera: * Evaluaciones sistemáticas en modelos multimodales de visión-lenguaje mediante bancos de prueba especializados como HallusionBench (Guan et al., 2024) revelan que la reducción en la capacidad de la red acentúa las ilusiones visuales y los sesgos lingüísticos no fundamentados en la imagen (language hallucination vs. visual illusion). * Modelos pequeños sometidos a estímulos ambiguos o degradados tienden a completar secuencias basándose en prioris estadísticas del lenguaje más que en la evidencia visual real.
A2.3.2 Riesgos críticos en vehículos aéreos no tripulados (UAVs)¶
En una misión de navegación aérea autónoma, los efectos de una alucinación trascienden la incorrección lingüística y se traducen en amenazas cinemáticas directas: 1. Alucinación de espacio libre: el modelo reporta erróneamente que una trayectoria está despejada al confundir sombras, reflejos o texturas complejas con áreas transitables, suprimiendo maniobras de evasión esenciales. 2. Alucinación de sintaxis o formato: la emisión de etiquetas no contempladas o la deformación del esquema JSON invalida el analizador sintáctico, interrumpiendo el flujo de control y dejando al vehículo sin acción defensiva durante múltiples ciclos de muestreo. 3. Deriva temporal y desacoplamiento dinámico: el modelo puede basar su razonamiento en estados superados o inventar una persistencia de obstáculos inexistente, comprometiendo la coherencia de la misión.
A2.4 Estrategias de mitigación implementadas en la arquitectura de la tesis¶
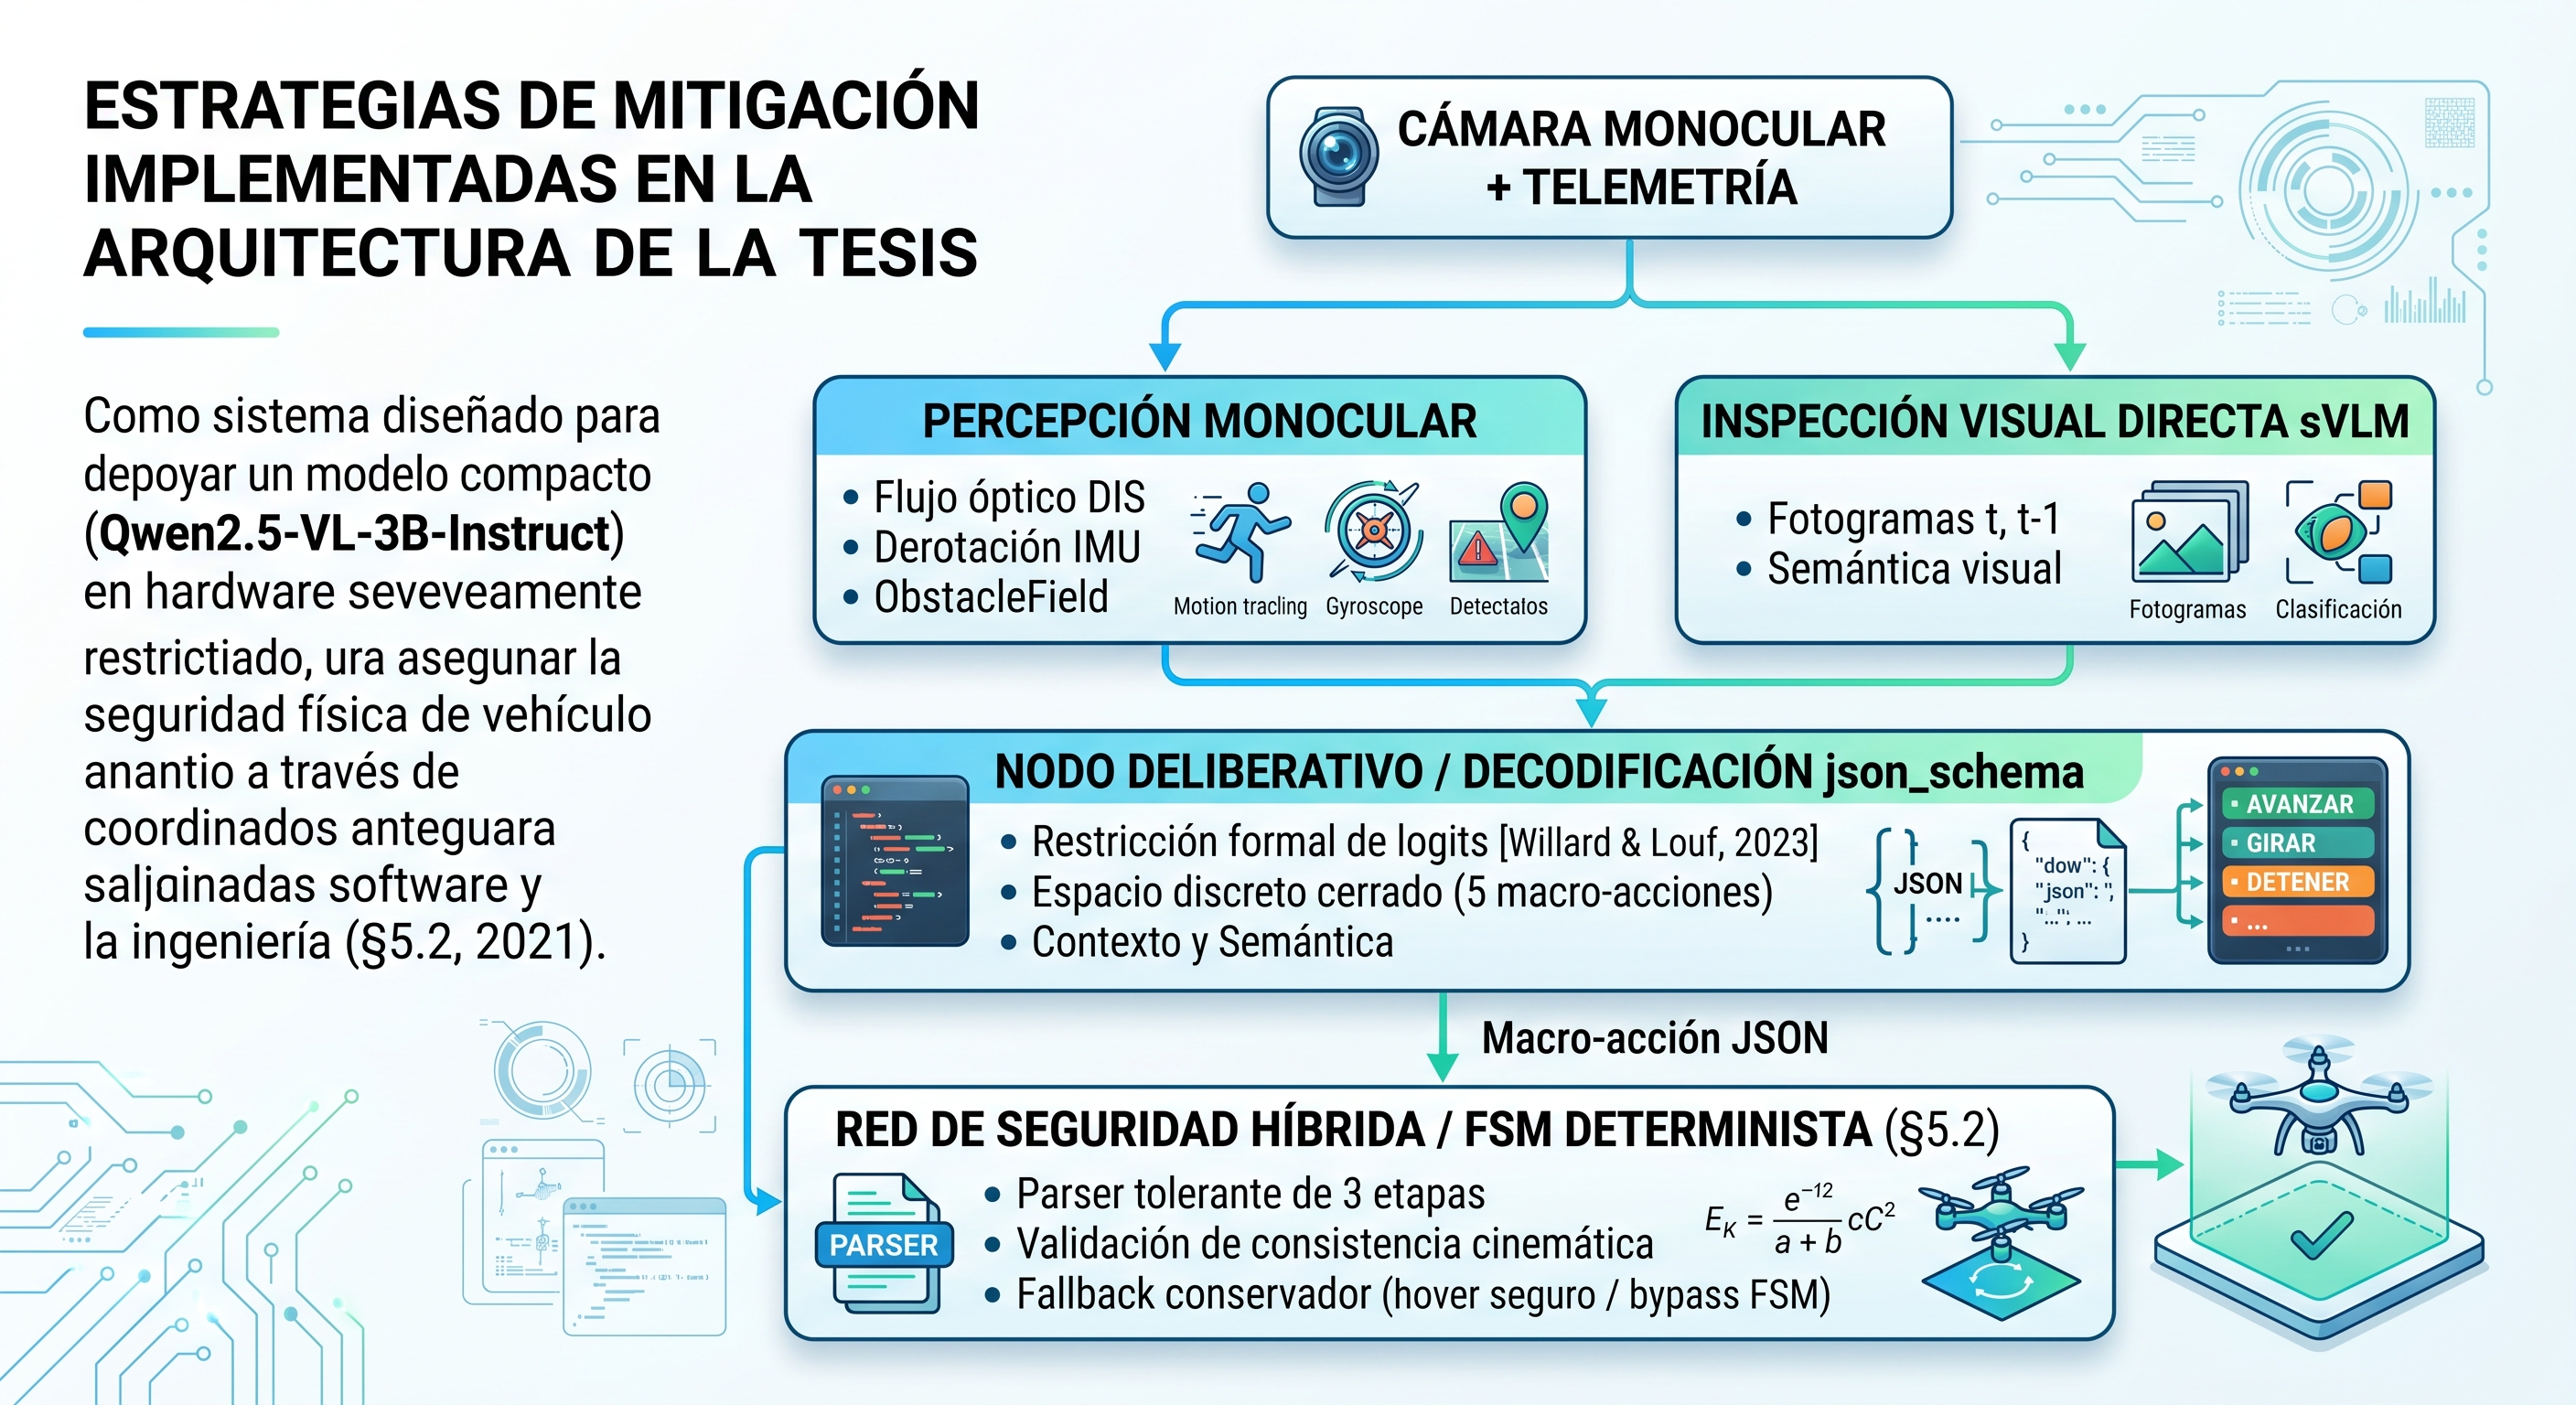
Para hacer viable el despliegue de un modelo compacto (LFM2.5-VL-1.6B, cap. 8 §8.1.2) bajo hardware severamente restringido sin comprometer la seguridad física del vehículo, esta tesis implementa un conjunto coordinado de salvaguardas de software e ingeniería:
-
Decodificación restringida a nivel de logits (
json_schema): En lugar de confiar en el seguimiento heurístico del prompt, el motor de inferencia enmascara en tiempo de generación cualquier token que viole la gramática del esquema JSON (Geng et al., 2025; Raspanti et al., 2025; Willard & Louf, 2023). Esto garantiza matemáticamente un 100% de validez estructural, erradicando por completo las alucinaciones de formato (§8.2.1). -
El modelo describe; el código decide la geometría (§8.3): El modelo no genera velocidades ni elige macro-acciones: clasifica sectores, imágenes o parches del mapa en enumeraciones cerradas (
free/blocked, cinco clases de terreno), y el código traduce esa descripción a una sub-meta en coordenadas del mundo o a una puntuación de ruta. Esta discretización suprime alucinaciones numéricas continuas y deja toda la cinemática en una función de traducción determinista y acotada (action_to_command(), §8.4). -
Arquitectura de dos lazos con un lazo rápido determinista (§5.1.2 y §8.2.2): La capa deliberativa no ejerce control directo sobre los actuadores. El lazo rápido de flujo óptico y TTC es el único que comanda velocidades y reacciona a lo inminente en el mismo ciclo; una respuesta inválida, tardía u obsoleta se descarta sin sustituirse por una decisión inventada, y un barrido sin respuesta válida cae a un escape vertical determinista.
-
Medición contra etiquetas de referencia antes del vuelo (§10.13): Cada pregunta que se le hace al modelo se evalúa fuera de vuelo contra una etiqueta independiente; la que no supera el criterio no se lleva al lazo. Por eso, con la configuración por defecto, las preguntas del lazo lento las responde una red de profundidad estimada y el VLM queda en el plan de ruta, donde sí aporta señal.
Conclusión sintética¶
Los desafíos de capacidad limitada y susceptibilidad a alucinaciones propios de los SLMs no deben resolverse mediante el escalado indiscriminado de parámetros —inviable en hardware de borde—, sino a través de una estricta disciplina de ingeniería de sistemas: decodificación gramaticalmente guiada, discretización del espacio de respuesta, acoplamiento jerárquico con un lazo rápido determinista y medición de cada capacidad antes de confiarle una decisión.